
-
お電話でのお問い合わせ045-555-9505
- メールでのお問い合わせ

お電話でのお問い合わせ045-555-9505
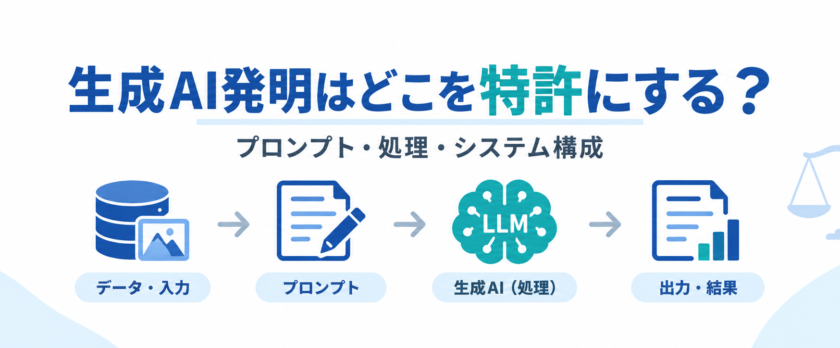
生成AIを使ったサービスを開発している方から、
「ChatGPTを使っているだけでも特許になるの?」
「LLMそのものを作っていなくても特許は取れる?」
「生成AIのどの部分を発明として考えればいい?」
と聞かれることがあります。
結論からいうと、生成AIを使った発明でも十分に特許になる可能性があります。
しかも、自社で大規模言語モデルそのものを開発している必要はありません。
ChatGPT、Gemini、Claudeなど、既存の大規模言語モデル(LLM)を利用している場合でも、
といった生成AIの前後・周辺の処理構成に工夫があれば、特許化を検討できます。
この記事では、生成AIを使った発明の「どこ」が特許になるのかを、実際の特許取得事例も交えて解説します。
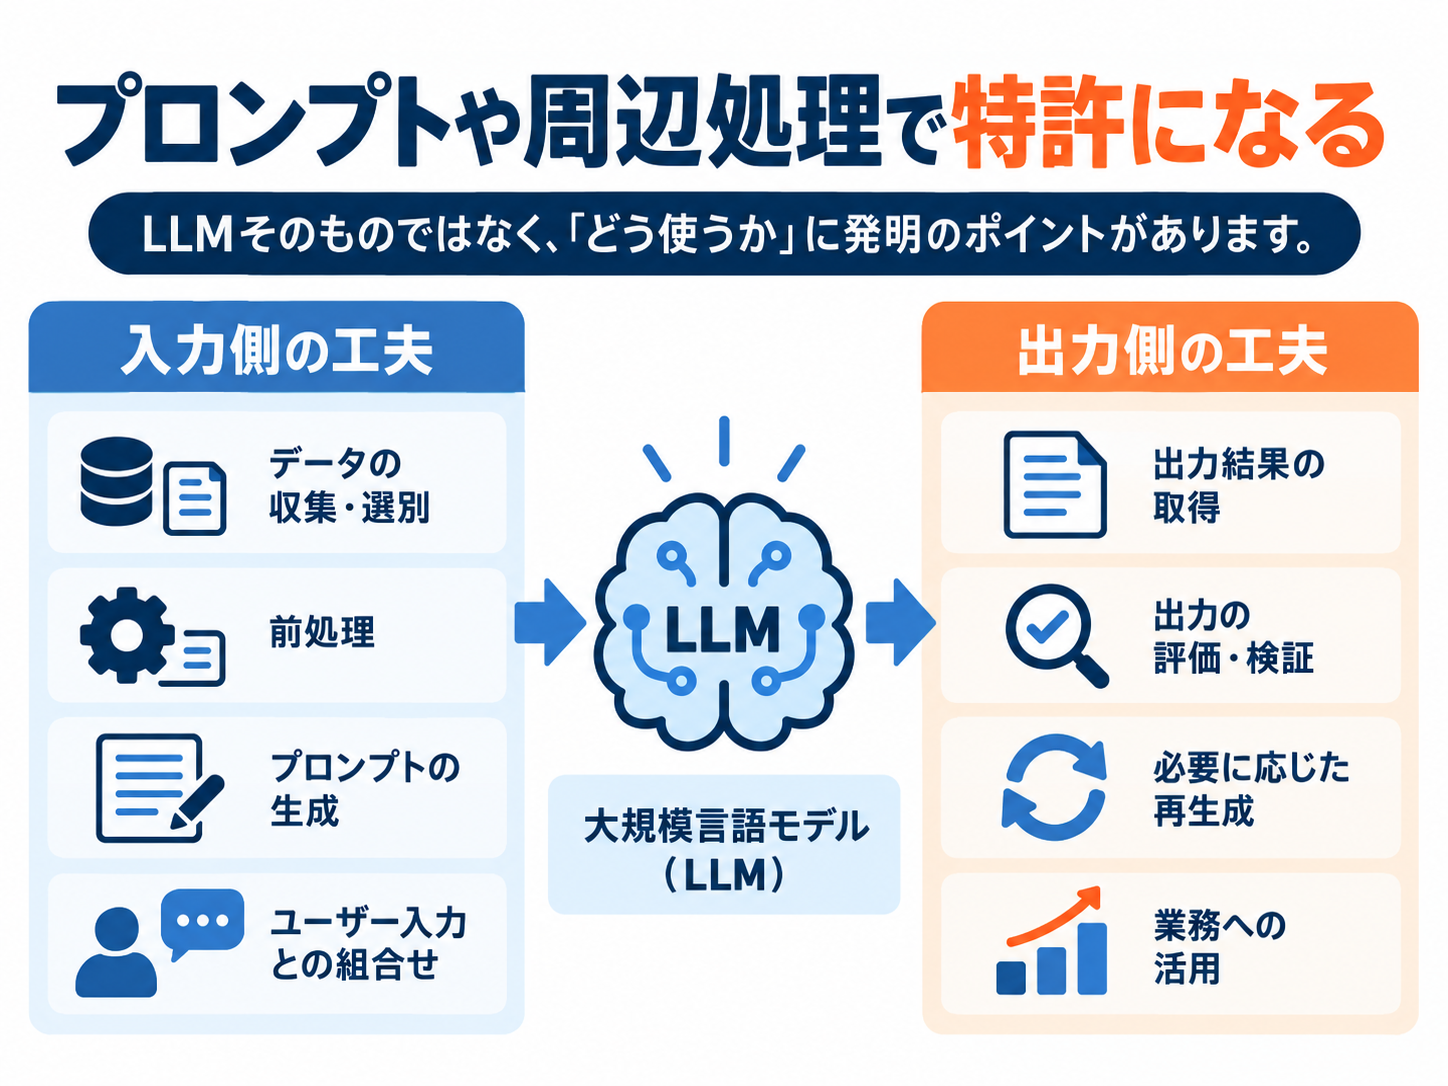
システム系の特許を考える場合、基本となるのは、
入力
→ 処理
→ 出力
という流れです。
生成AIを使ったシステムも同じです。
例えば、シンプルに整理すると、
データを取得する
↓
プロンプトを生成する
↓
LLMへデータとプロンプトを入力する
↓
LLM側で処理・演算を行う
↓
出力結果を取得する
↓
目的に応じて成果物として利用する
という構成になります。
この流れのどこに独自の工夫があるかを見ていくのが、生成AI特許を考えるうえで非常に重要です。
最初に考えるのが、入力側です。
生成AIに何か処理をさせるためには、基本的に何らかのデータが必要です。
例えば、
などです。
ここで、
「どのデータを取得するのか」
自体に工夫がある場合もあります。
また、単にデータを取得するだけでなく、
といった前処理も発明のポイントになり得ます。
次に重要なのがプロンプトです。
ChatGPTやGemini、ClaudeなどのLLMでは、
どのようなプロンプトを入力するか
によって結果が大きく変わります。
そのため、
「プロンプトを使っています」
だけではなく、
どのような条件で、どのようなプロンプトを生成するのか
に工夫がある場合、特許として検討できる可能性があります。
例えば、
といった処理です。
つまり、固定された一文のプロンプトそのものだけを見るのではなく、プロンプトを作る仕組み全体を見ることが大切です。
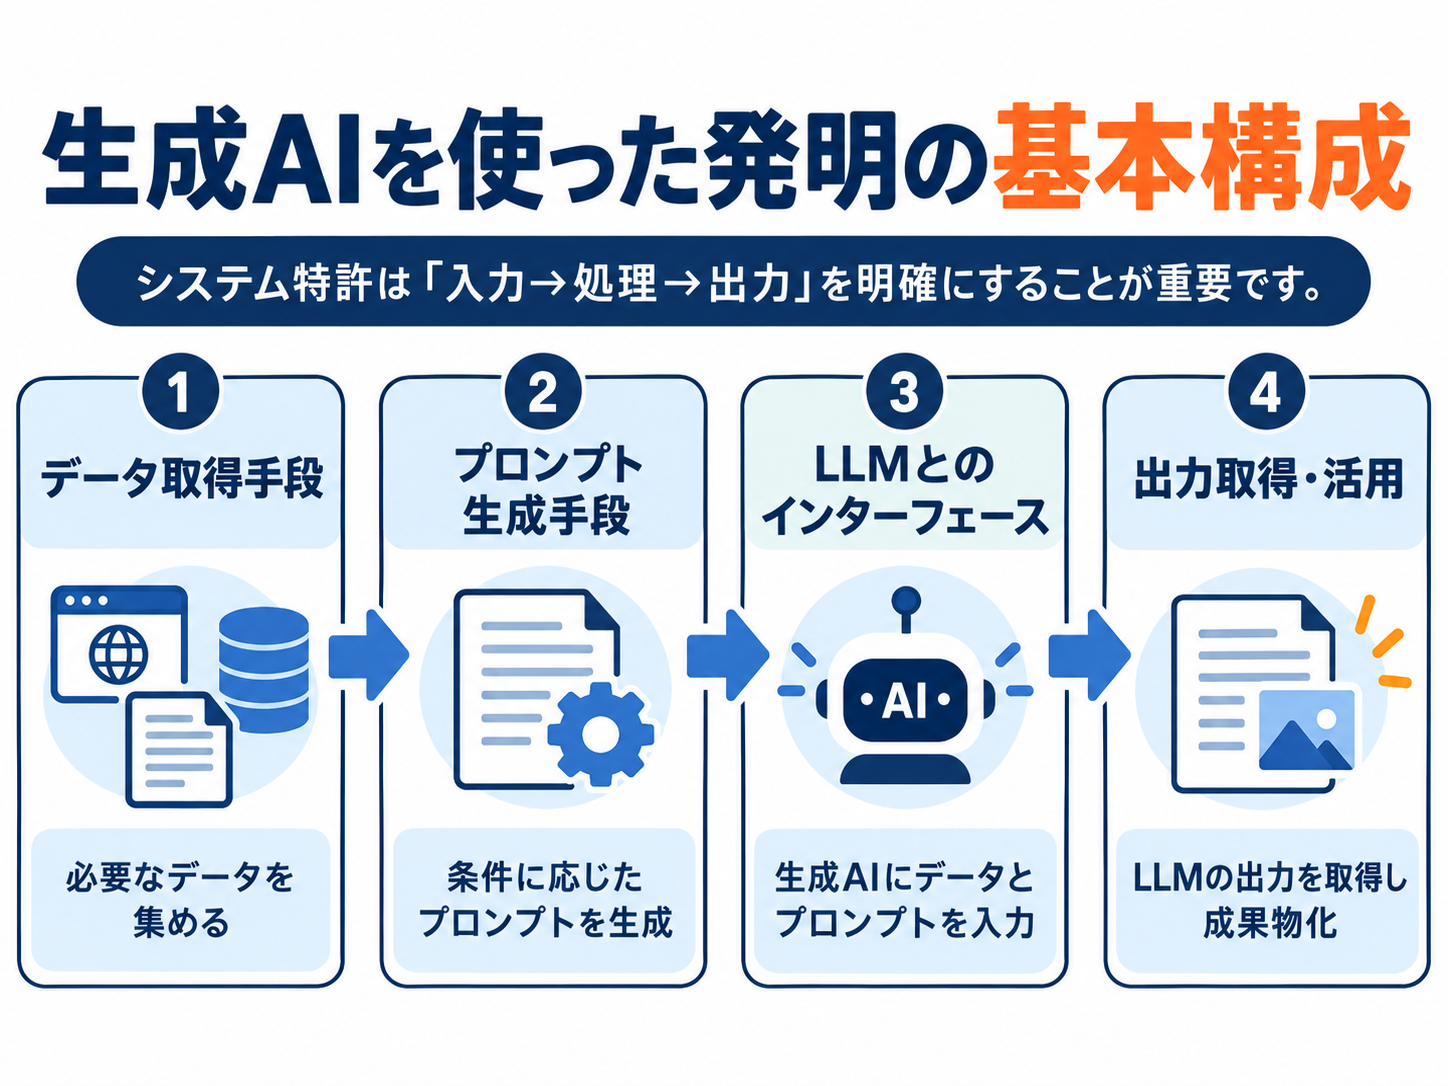
次に、大規模言語モデルとの接続部分です。
システム側から、
をLLMへ送信し、LLM側で処理された結果を受け取ります。
この部分を、この記事では分かりやすくLLMとのインターフェースと呼びます。
LLMそのものはChatGPTやGeminiなど既存のサービスであっても構いません。
重要なのは、
「既存のLLMを、自分のシステムの中でどう使うか」
です。
例えば、
といった構成にも工夫の余地があります。
LLMから回答が返ってきたら終わり、とは限りません。
実際のサービスでは、その出力をさらに、
といった処理を行うことがあります。
この出力後の処理にも特徴があれば、発明のポイントになり得ます。
生成AIを使った特許では、
LLMの前だけでなく、LLMの後まで含めてシステム全体を見る
のが重要です。
ここは、よく誤解されるところです。
「ChatGPTを使っているだけだから特許にはならない」
と考える方がいます。
しかし、必ずしもそうではありません。
もちろん、
単にChatGPTに質問を送って、その回答をそのまま表示するだけ
であれば、独自の発明としては弱いでしょう。
一方で、
などに新しい処理構成があれば、特許になる可能性があります。
つまり、生成AI特許で重要なのは、
「どのAIを使っているか」ではなく、「そのAIをどう使って課題を解決しているか」
です。
当事務所で実際に特許取得をサポートした案件に、**生成AIを使った「文章生成装置」**があります。
この発明も、ChatGPTやGeminiなどの大規模言語モデルそのものを新しく作ったわけではありません。
ポイントは、その使い方にあります。
生成AIで章立てされた長文を作ろうとすると、従来は一貫性が崩れることがありました。
例えば、
第1章では主人公が「太郎・次郎」だったのに、
第2章・第3章と進むうちに、
「三郎・次郎」
になってしまったり、
後半では人物設定そのものが変わってしまったりすることがあります。
長文になるほど、
の整合性が崩れやすくなるという問題です。
そこで、この発明では、
まずテーマや章立てなどのデータを用意します。
そして、
第1章を生成
↓
第1章の出力文章を取得
↓
その文章を第2章を作るためのプロンプトへ取り込む
↓
第2章を生成
↓
第1章・第2章までの内容を次の生成へ反映する
というように、順番に処理します。
前の章の出力を次の章のプロンプトに取り込むことで、
それまでの文脈を維持しながら続きの文章を生成する
という仕組みです。
これによって、
などの整合性を保ちやすくなります。
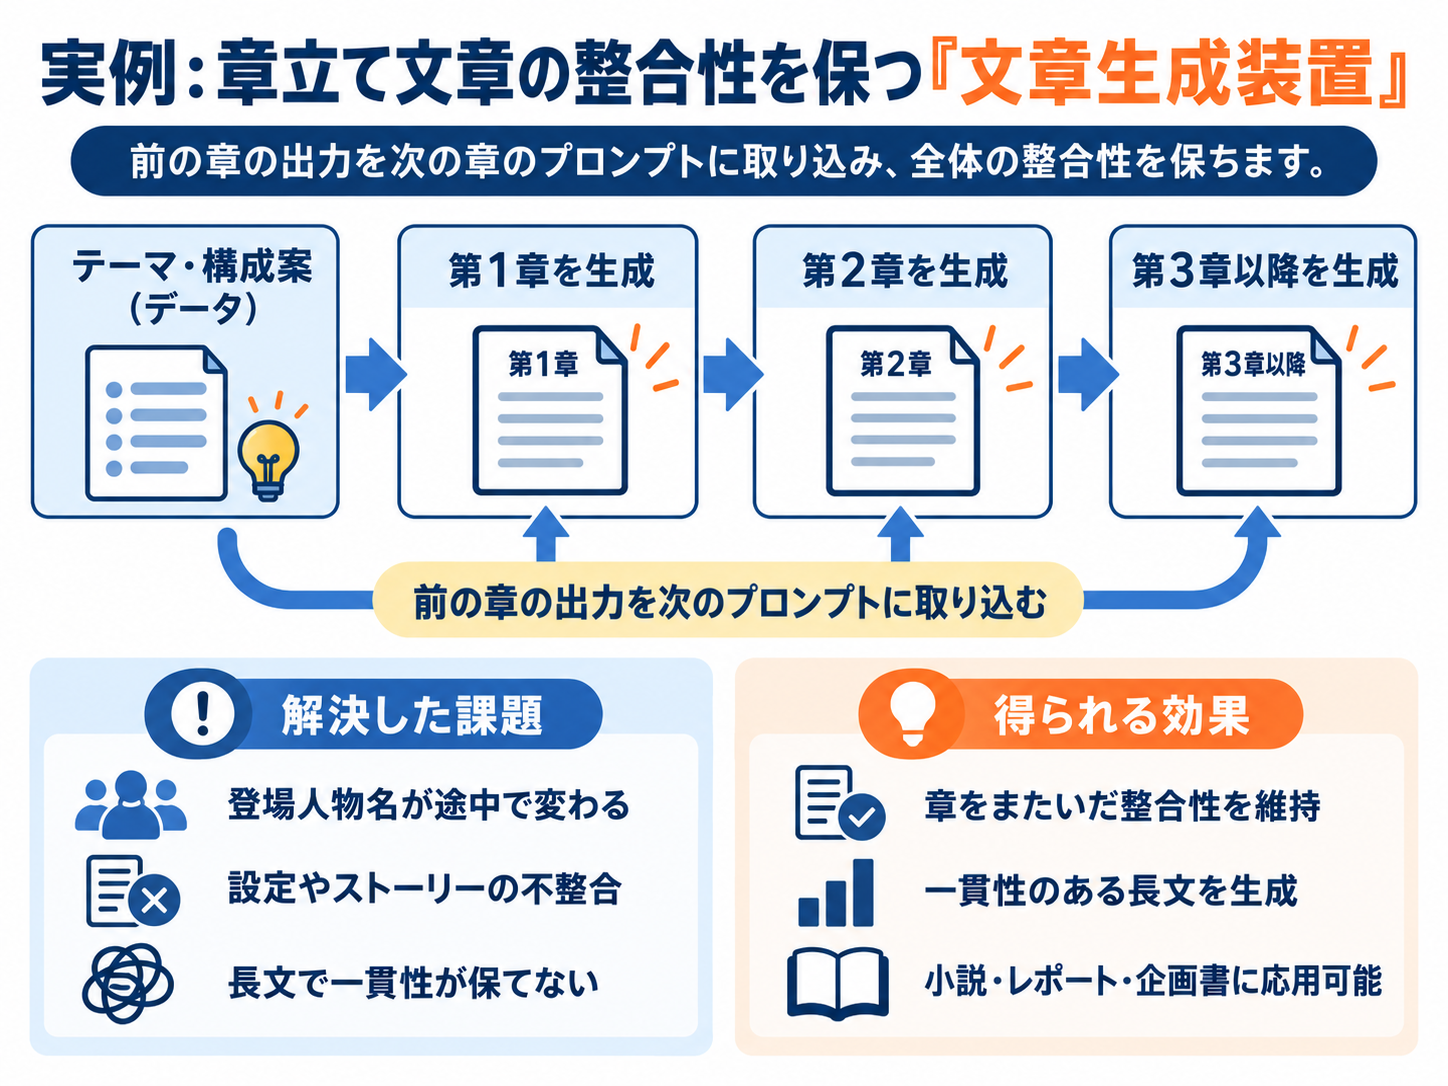
この事例を見ると、
「生成AIそのものを開発しなくても特許になる」
ということが分かりやすいと思います。
発明のポイントは、
前に生成した文章を、次の文章生成用のプロンプトに反映するという処理構成
です。
つまり、
データ取得
↓
プロンプト生成
↓
LLMで文章生成
↓
出力取得
↓
次のプロンプトへ反映
という仕組みそのものが重要です。
このように、プロンプトやその周辺処理をきちんとシステム構成として整理することで、生成AIを利用した発明でも特許を取得できる可能性があります。
ただし、
プロンプトを工夫したら何でも特許になる
という意味ではありません。
特許にするためには、その処理によってどのような課題を解決しているのかを明確にする必要があります。
例えば今回の文章生成装置なら、
課題
長文生成では章をまたいだ整合性が崩れやすい
という問題があり、
解決手段
前章までの出力を次章用のプロンプトに取り込む
という処理によって、
効果
長文全体の整合性を保ちやすくする
という関係になっています。
この、
課題 → 解決手段 → 効果
を明確に説明することが重要です。
そして、その処理構成について新規性・進歩性などの特許要件を満たす必要があります。
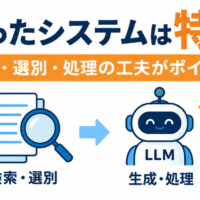
生成AIを利用したシステムでは、例えば次のような部分を確認します。
生成AI特許では、LLMそのものよりも、こうした周辺の処理に発明の種があることが多いと考えています。
この考え方は、生成AI単体だけではありません。
例えばRAGでは、
データを検索
↓
必要な情報を選択
↓
プロンプトに組み込む
↓
LLMへ入力
↓
回答を生成
という流れがあります。
AIエージェントであれば、
といった処理があります。
このようなところにも発明のポイントが生まれます。
生成AIを使ったサービスを作っている場合は、できれば公開前に一度特許性を検討することをおすすめします。
例えば、
などでシステムの仕組みを公開すると、特許の新規性に影響する可能性があります。
そのため、
システム構成がある程度固まった段階
で一度、
「どこを特許にできそうか」
を整理しておくのがよいでしょう。
生成AIを使った発明では、
ChatGPTやGeminiそのものを発明する必要はありません。
重要なのは、
という生成AIの周辺処理です。
今回紹介した文章生成装置のように、
前の出力を次のプロンプトへ取り込む
という処理構成でも、それによって新しい課題を解決し、新規性・進歩性等の要件を満たせば、特許になる可能性があります。
生成AIサービスを開発している方は、
「AIを使っているだけだから特許にならない」
と最初から決めつけず、
システムのどこに独自の処理があるのか
を一度整理してみることをおすすめします。
遠山総合特許事務所では、
などについて、特許化できるポイントの検討からご相談いただけます。
システム全体の処理フローを確認しながら、どの部分を発明として押さえるべきかをご提案します。
執筆・監修:弁理士 遠山敬一
この記事へのトラックバックはありません。




この記事へのコメントはありません。