
-
お電話でのお問い合わせ045-555-9505
- メールでのお問い合わせ

お電話でのお問い合わせ045-555-9505
ChatGPTなどの生成AIを使ったサービスが増える中、
「プロンプトは特許になるのでしょうか?」
という質問を受けることがあります。
結論からいうと、プロンプトに関連する技術は、十分に特許の対象になり得ます。
ただし、
「このプロンプト文そのものを特許で独占する」
というより、
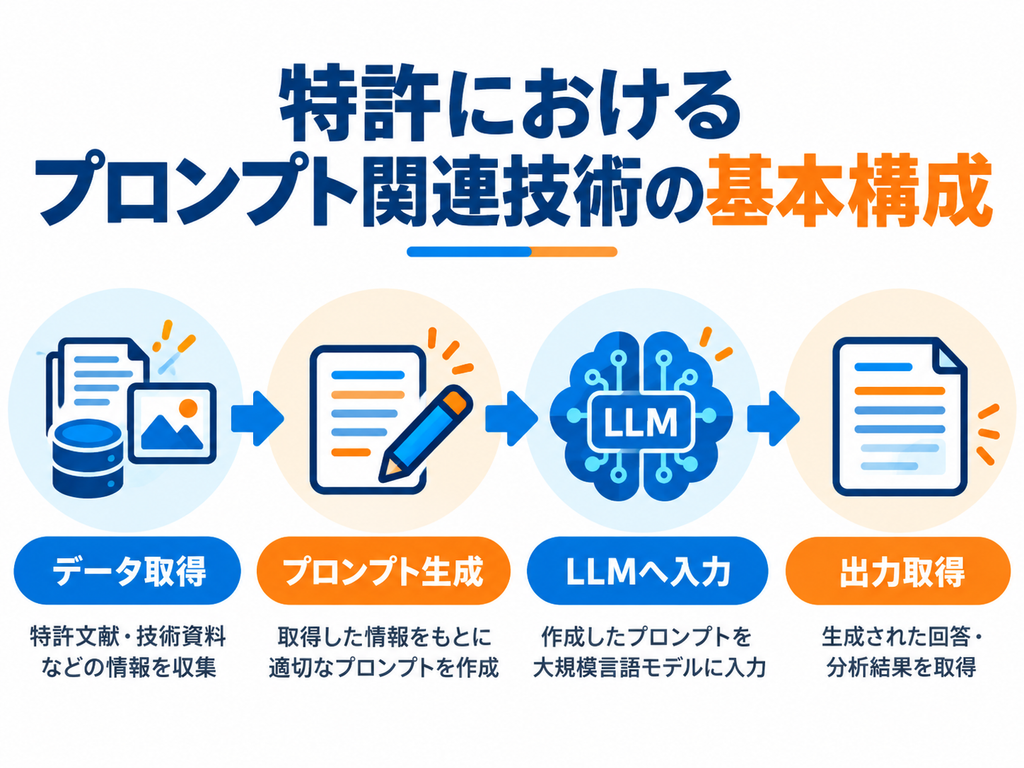
どのようなデータを取得し、そのデータからどのようにプロンプトを生成し、LLM(大規模言語モデル)へ入力して、得られた結果をどう利用するのか
という一連の情報処理として発明を捉えることが重要です。
実際、特許庁もAI関連技術の審査事例として「大規模言語モデルに入力するためのプロンプト用文章生成方法」を取り上げ、プロンプト生成に関する発明の進歩性を検討しています。
生成AIサービスの特許を考えるとき、例えば次のような構成が考えられます。
データ取得
↓
プロンプト生成
↓
データとプロンプトをLLMへ入力
↓
LLMから出力を取得
↓
その出力を次の処理に利用
という流れです。
重要なのは、
単に「ChatGPTへこの文章を入力する」という話ではなく、その前後を含めた情報処理の仕組み
です。
例えば、
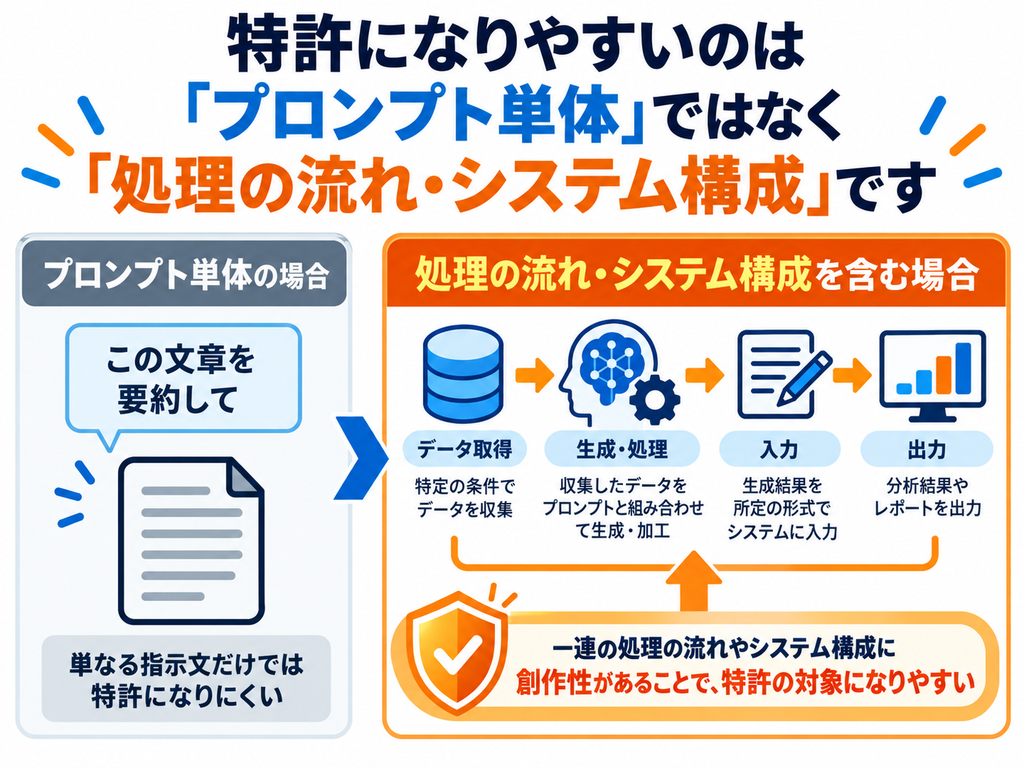
「この文章を要約してください」
というプロンプトを人が入力するだけでは、それ自体を特許として広く権利化するのは難しいでしょう。
一方で、
ユーザーから情報を取得する。
取得した情報を一定のルールで加工する。
その情報に応じてプロンプトを自動生成する。
生成したプロンプトをLLMへ入力する。
得られた出力をさらに次の処理に使う。
という構成になれば、話は変わります。
つまり、
「プロンプト」という言葉だけを見るのではなく、プロンプトがシステムの中でどのように生成され、利用されているかを見る
ことが重要です。
特許庁のAI関連審査事例でも、質問文に関連する付加文章を生成し、それを組み込んでLLM向けのプロンプトを作成する方法が例示されています。そして、その具体的な生成方法によっては進歩性が認められる例も示されています。
当事務所で実際に扱い、特許になった生成AI関連技術の一つに、文書生成装置があります。
長い文章を生成AIに作らせると、よく起こる問題があります。
例えば、
第1章では主人公が東京に住んでいたのに、第3章では別の場所に住んでいる。
第1章で設定した人物の性格が、後の章で変わってしまう。
前の章で起きた出来事と、その後の章の内容がつながらない。
といった問題です。
短い文章であれば大きな問題にならなくても、章立てされた長文になると、文章全体の整合性を維持することが難しくなります。
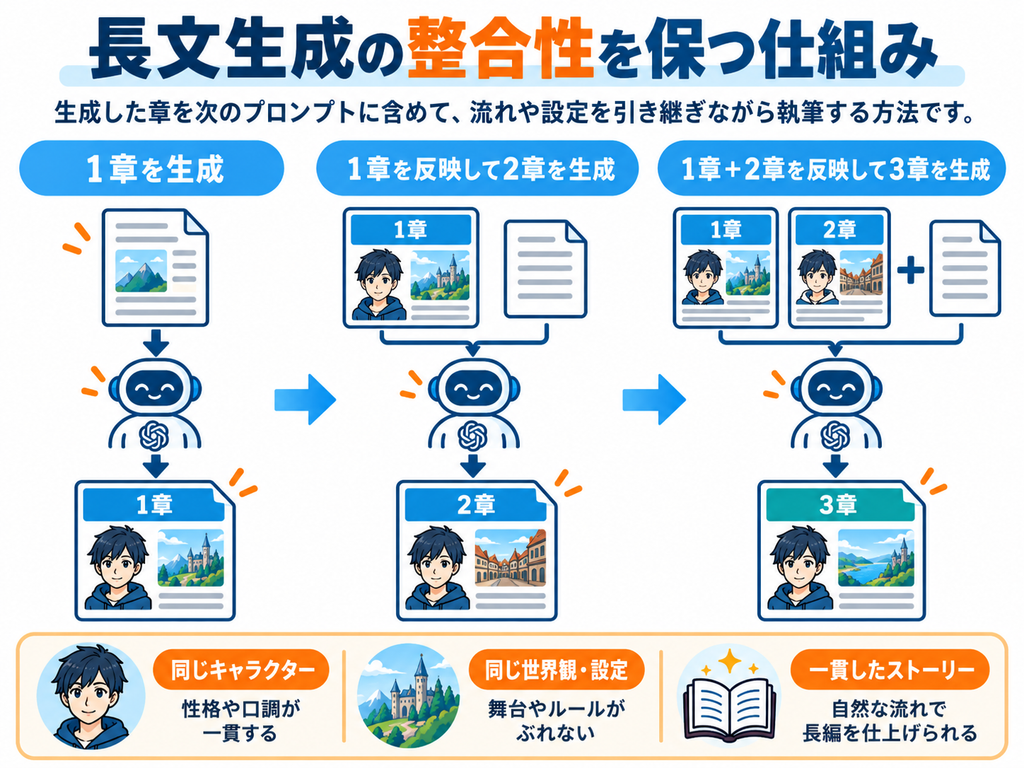
この問題に対して、例えば次のような処理を行います。
まず、第1章を生成します。
次に、第2章を生成するときには、
第1章で生成された文章をプロンプトへ含めたうえで、「この続きとなる第2章を生成してください」とLLMへ入力します。
さらに第3章では、
第1章と第2章で生成された文章を踏まえて、第3章を生成するためのプロンプトを作ります。
この処理を繰り返します。
すると、前の章の人物設定やストーリー、世界観などを次の章へ反映しやすくなります。
ポイントは、
「第2章を書いてください」という文章そのもの
ではありません。
例えば、
前に生成された文章を取得する。
取得した文章を次のプロンプトを生成するためのデータとして利用する。
そのプロンプトをLLMへ入力する。
LLMから次の文章を取得する。
さらにその結果を次の処理へ利用する。
という情報処理の流れがあります。
このような仕組みに、
と判断されれば、特許として認められる可能性があります。
もちろん、実際に取得した特許はここで説明した内容よりも多くの構成要素を含んでおり、これほど単純なものではありません。
ただ、基本的な考え方としては、
「プロンプトの文章を特許にする」のではなく、「プロンプトを利用した処理の仕組みを特許にする」
と考えると分かりやすいと思います。
生成AI関連発明では、
どのデータを使うか
も非常に重要です。
例えば、
ユーザー属性、
過去の出力結果、
データベースから取得した情報、
画像、
過去の会話履歴、
業務データ、
などを取得し、その内容に応じてプロンプトを生成することがあります。
つまり、
データ取得手段とプロンプト生成手段の関係
を見るわけです。
さらに、
「どのデータを、どの条件で選び、どうプロンプトへ組み込むのか」
というところに特徴があれば、発明のポイントになる可能性があります。
一方で、
「従来人がやっていた処理を、そのままChatGPTにやらせました」
というだけでは、特許としては弱い場合があります。
特許庁のAI審査事例でも、生成AIを使ったという事実だけで当然に進歩性が認められるわけではなく、具体的な処理内容や技術的特徴が判断されています。
ですから、
AIを使っているかどうかではなく、AIをどう使って課題を解決しているのか
を見る必要があります。
プロンプト関連技術について特許を検討するとき、私は特に次のような点を見ます。
単なる文章の工夫ではなく、
処理の流れに特徴があるか
を見ることが重要です。
例えば、
「こういうプロンプトを使うと、ChatGPTから非常に良い回答が出ます」
というだけの場合です。
もちろん、それ自体が事業上重要なノウハウであることはあります。
しかし、特許として考える場合には、
なぜそのプロンプトになるのか
まで一段掘り下げる必要があります。
例えば、
ユーザーの入力内容を分析する。
分析結果によってテンプレートを変更する。
必要な参考データを選択する。
そのデータを組み込んでプロンプトを生成する。
AIの出力結果を評価し、不十分なら追加データを加えて再生成する。
というシステムであれば、発明として整理しやすくなります。
これも今後の記事にできる論点ですが、
必ずしも実際のプロンプト全文をそのまま特許請求の範囲に書く必要はありません。
むしろ、
「取得した情報に基づいてプロンプトを生成するプロンプト生成手段」
「第1の生成結果を含む入力情報に基づいて第2のプロンプトを生成する手段」
など、情報処理として抽象化して表現することがあります。
どこまで具体的に書くべきかは、発明のポイントや先行技術によって変わります。
ここは生成AI関連特許の明細書を作成するときに非常に重要なところです。
生成AIを使ったサービスは、開発スピードが非常に速い分野です。
ChatGPTなど既存のLLMを利用すれば、小規模な会社でも短期間でサービスを作ることができます。
その一方で、
同じような仕組みを他社も短期間で開発できる
という問題があります。
ですから、
「AIそのものは自社開発ではないから、特許は無理だろう」
と考える必要はありません。
むしろ、
既存のLLMをどのような情報処理に組み込み、どのような課題を解決しているか
に特徴があるなら、早い段階で特許を検討する価値があります。
プロンプト関連技術は、十分に特許の対象になり得ます。
ただし、
プロンプトの文章そのものを独占する
という発想よりも、
データ取得 → プロンプト生成 → LLMへの入力 → 出力取得 → 次の処理
という一連の情報処理として考えることが重要です。
特に、
過去の出力を次のプロンプトへ反映する。
入力データによってプロンプトを変える。
複数のデータから最適なプロンプトを生成する。
出力結果に応じてプロンプトを再生成する。
といった処理に特徴があり、それによって技術的な課題を解決しているのであれば、特許化を検討する価値があります。
当事務所でも、実際に生成AIを使った文書生成技術について特許取得を支援した実績があります。
遠山総合特許事務所では、
「ChatGPTを使ったサービスを開発した」
「プロンプト生成の仕組みに特徴がある」
「生成AIサービスのどこを特許にすればよいか分からない」
「既存のLLMを使っているが特許になるか知りたい」
「サービス公開前に特許を検討したい」
といった段階からご相談いただけます。
AIそのものではなく、その前後にある情報処理まで含めて発明を見ることが、生成AI特許では重要です。
AIを使ったサービスは特許になる?
https://toyamapat.com/archives/1679
生成AIを使った発明はどこを特許にする?
https://toyamapat.com/archives/1727
AIで作ったアプリでも特許は取れる?
https://toyamapat.com/archives/1686
RAGを使ったシステムは特許になる?
https://toyamapat.com/archives/1766
AIエージェントを利用したシステムは特許になる?
https://toyamapat.com/archives/1782
執筆・監修:弁理士 遠山敬一
この記事へのトラックバックはありません。




この記事へのコメントはありません。